Relatório técnico: pgwd v1.1.1
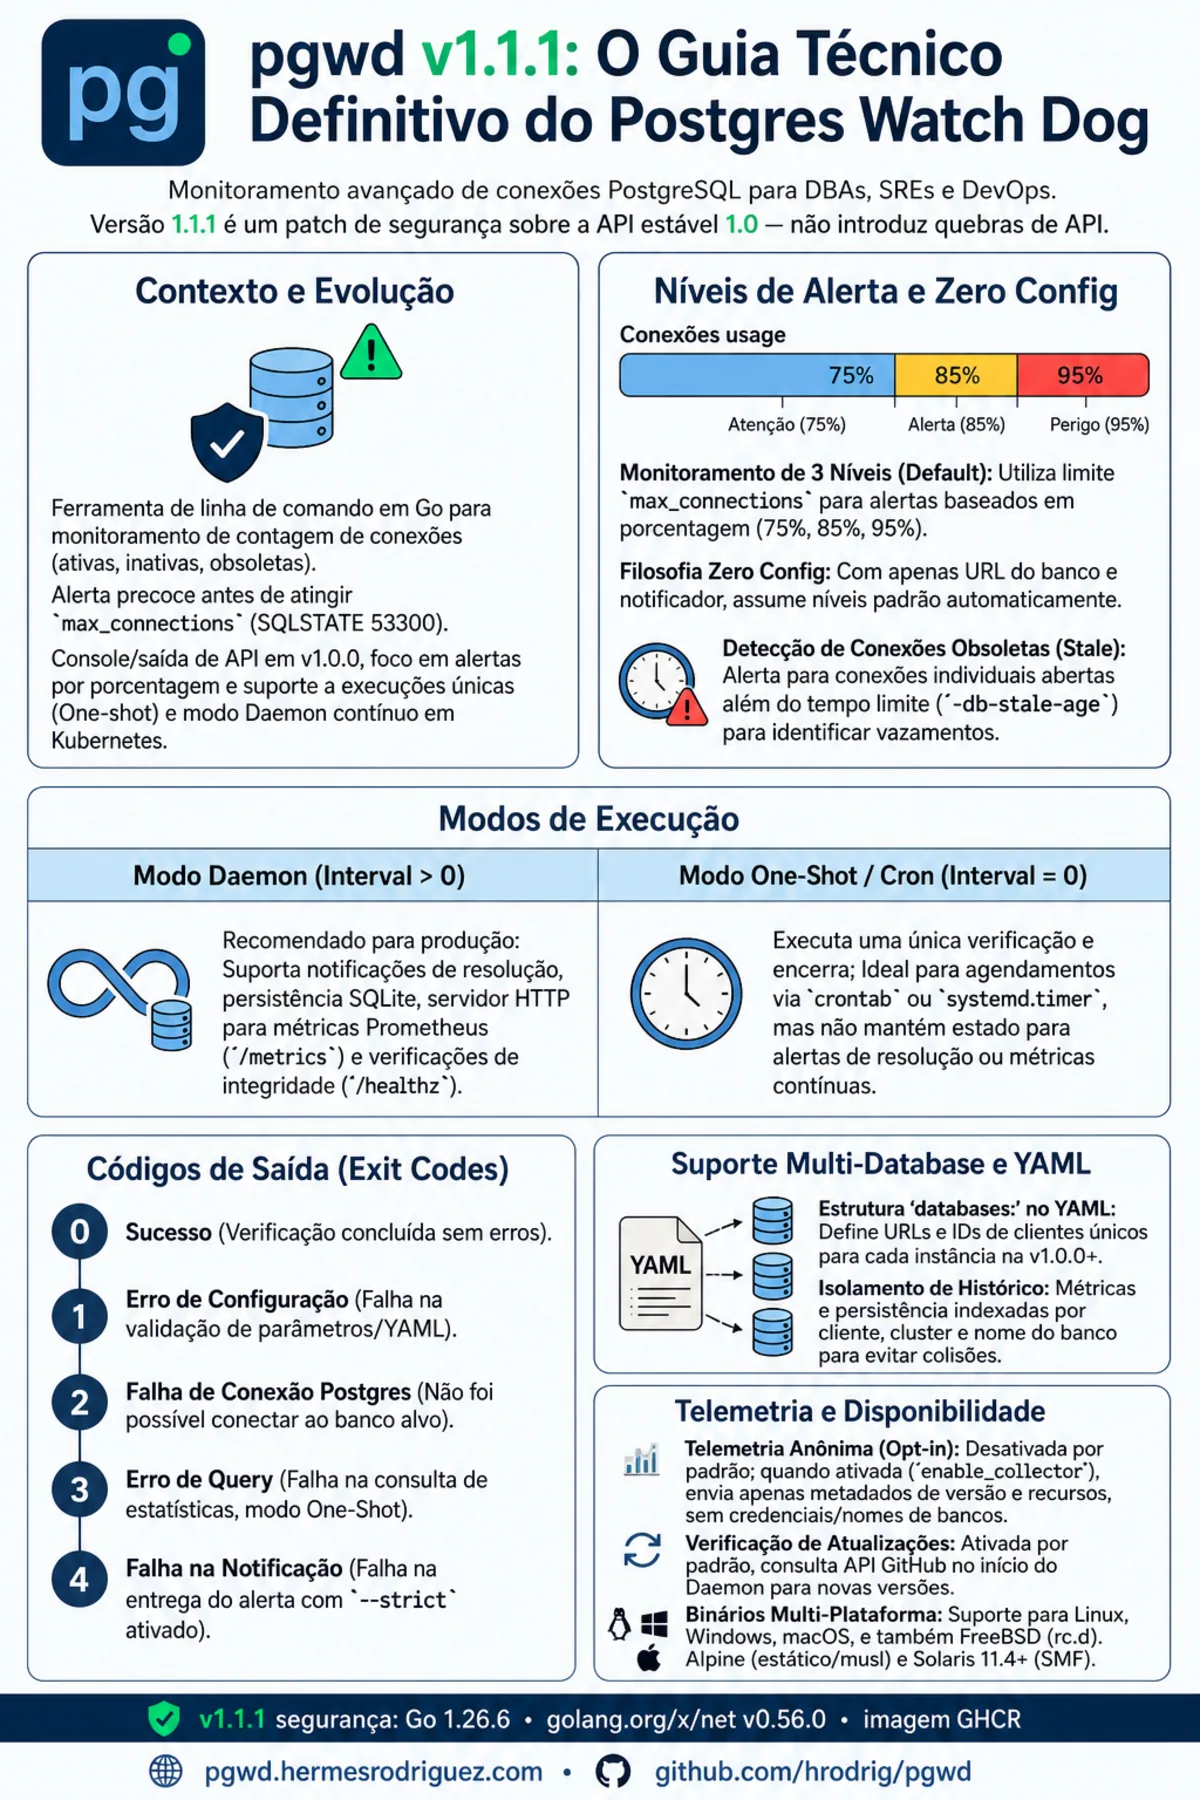
pgwd (Postgres Watch Dog) é um CLI em Go que amostra a pressão de conexões PostgreSQL e avisa antes de esgotar os slots. Não substitui um pooler como PgBouncer. É um watchdog especializado: visibilidade e alertas; a ação é tua.
v1.1.1 (2026-08-31) é um patch de segurança sobre a API estável 1.0. Sem breaking changes de config neste tag. Puxar o binário / imagem GHCR para Go 1.26.6 e golang.org/x/net v0.56.0.
1. Por que os slots importam
Em alta disponibilidade, slots PostgreSQL são escassos. Esgotá-los aparece como SQLSTATE 53300 (too many clients already). Slots livres não são só max_connections: o PostgreSQL reserva capacidade com superuser_reserved_connections e, desde PostgreSQL 16+, reserved_connections.
Sem slots, o tráfego da aplicação já está bloqueado. Costuma coincidir com pressão de CPU, I/O e memória (shared_buffers, work_mem) e pode anteceder OOM. O pgwd existe para a plantão ver Attention / Alert / Danger (e sessões stale) antes desse precipício.
2. Fluxo de dados e backends de métricas
Um ciclo:
- Check — consulta
pg_stat_activity(ativas, idle, início do backend, long queries opcionais). - Persistência — histórico para histerese, alertas de resolução e
/metrics. - Saída — CSV opcional; HTTP opcional
/metrics(Prometheus) e/healthz.
| Backend | Quando | Nota |
|---|---|---|
| SQLite (padrão) | Monitor local / um nó | Recomendado. Evita dependência circular: se a rede para o Postgres cair, o monitor continua a gravar localmente. |
| Postgres / Timescale | Histórico de frota | Centralizar métricas em SQL. |
| MySQL | Métricas já no MySQL | Dependência de rede extra; só se for o padrão da org. |
SQLite (e o store SQL) indexa por (client, cluster, database), não pelo host da URL. Dá um client único por entrada databases: se o mesmo nome de base existir em hosts diferentes.
Kubernetes: kube.postgres / -kube-postgres é port-forward com client-go, não um subprocesso kubectl. Não combinar databases: multi-entrada com kube postgres no mesmo processo (uma entrada + kube: sim).
3. Deteção e notificação
Conexões stale
Idade da sessão (início do backend) contra uma idade mínima e um limiar de contagem stale ≥ 1. Sessões idle eternas fragmentam memória e ocupam slots.
Três níveis e supressão de ruído
Utilização vs max_connections usa faixas percentuais (padrão ~75 / 85 / 95: Attention / Alert / Danger), mais idle e stale. Só dispara o nível mais alto do ciclo — evita tempestade de alertas quando a carga atravessa várias faixas num intervalo.
Desde v1.1.0, os notifiers de limiar estão silenciosos por padrão: transição, escalada e desescalada — não cada intervalo enquanto o mau estado persiste. notifications.repeat_while_firing restaura o spam por intervalo da v1.0. PagerDuty: dedup_key estável e event_action: resolve na recuperação.
Falha de conexão notifica sempre (notifiers configurados e não -dry-run). Sem flag opt-in. “too many clients already” classifica-se como too_many_clients.
Canais: Slack, Grafana Loki, PagerDuty, Microsoft Teams, webhook genérico (HMAC-SHA256 opcional). -test-max-connections sobrescreve o limite só no monitor para ensaiar Danger sem alterar o GUC real.
4. Cadeia de fornecimento (1.0+) e segurança v1.1.1
- SBOM — SPDX e CycloneDX no GitHub Releases.
- Cosign — imagens GHCR e bundle de checksums (Cosign v3).
- Imagem — distroless static Debian, non-root.
- v1.1.1 — Go 1.26.6 e
golang.org/x/netv0.56.0 (GO-2026-5942); Grype--fail-on high.
5. Multi-database e quebras da 1.0
databases: é obrigatório (mesmo para um destino). db: desapareceu. Ver UPGRADE-0.9-to-1.0.
Limiares fixos total / active desapareceram. Usa -db-threshold-levels. notify_on_connect_failure desapareceu porque a falha de conexão sempre alerta.
Códigos de saída
| Código | Evento | Nota DBRE |
|---|---|---|
| 0 | Sucesso | Check normal. |
| 1 | Config / validação | Falhar o deploy (CI). |
| 2 | Falha de conexão | Um destino: exit 2. Multi-database: log, salta o destino, continua. |
| 3 | Falha de query de stats | One-shot; o daemon não sai por erros de query. |
| 4 | Falha de notificador | Com --strict. |
6. Repositórios
| Repo | Papel |
|---|---|
| hrodrig/pgwd | CLI, checker, notifiers, imagem GHCR, releases. |
| hrodrig/pgwd-selfhosted | Compose, Helm, run/. Não é o motor Go. |
Exemplos de operador: pgwd-selfhosted/run. Changelog: CHANGELOG.md.