Rapport technique : pgwd v1.1.1
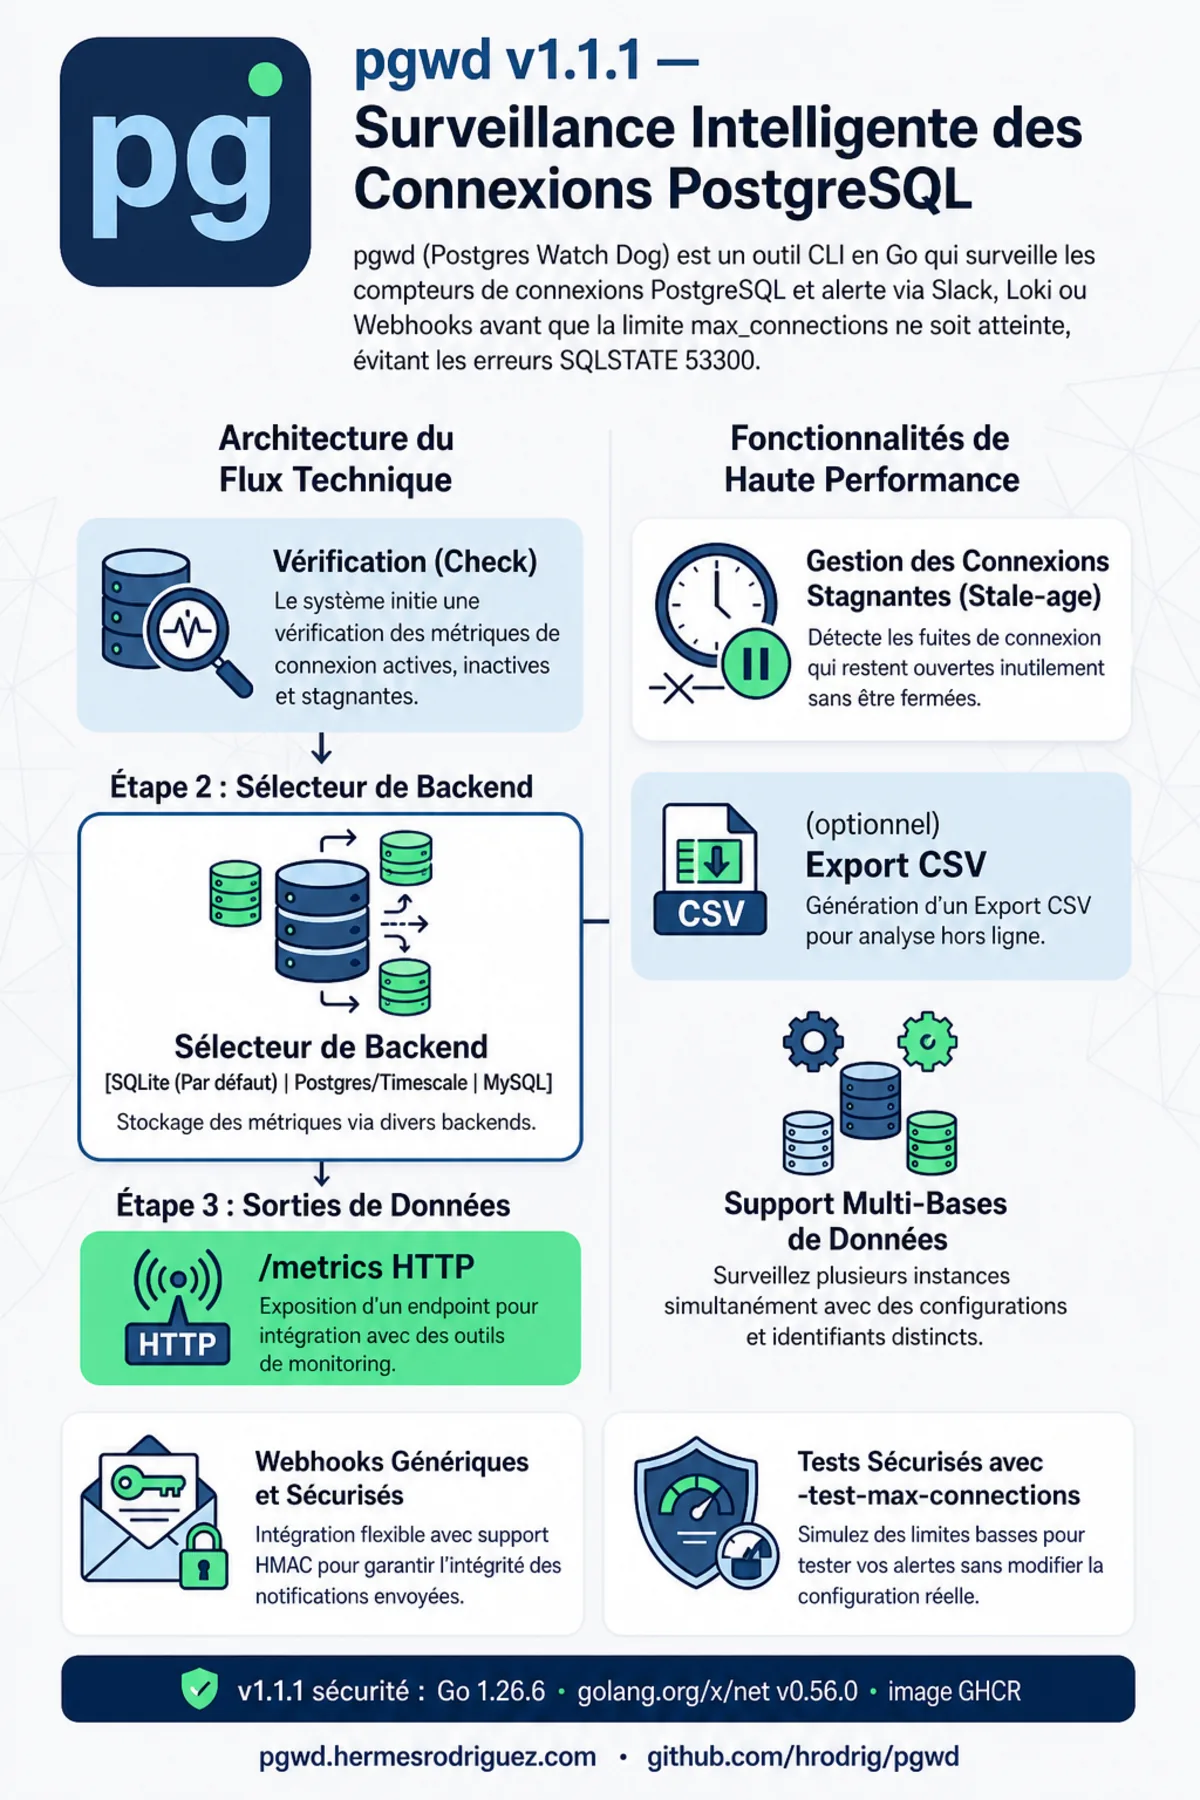
pgwd (Postgres Watch Dog) est un CLI Go qui échantillonne la pression de connexions PostgreSQL et alerte avant l’épuisement des slots. Il ne remplace pas un pooler comme PgBouncer. C’est un watchdog spécialisé : visibilité et alertes ; l’action reste la tienne.
v1.1.1 (2026-08-31) est un correctif de sécurité sur l’API stable 1.0. Aucun breaking change de config dans ce tag. Tirer le binaire / l’image GHCR pour Go 1.26.6 et golang.org/x/net v0.56.0.
1. Pourquoi les slots comptent
En haute disponibilité, les slots PostgreSQL sont rares. Les épuiser se traduit par SQLSTATE 53300 (too many clients already). Les slots libres ne valent pas max_connections : PostgreSQL réserve de la capacité via superuser_reserved_connections et, depuis PostgreSQL 16+, reserved_connections.
Sans slots, le trafic applicatif est déjà bloqué. Cela coïncide souvent avec une pression CPU, I/O et mémoire (shared_buffers, work_mem) et peut précéder un OOM. pgwd existe pour que l’astreinte voie Attention / Alert / Danger (et les sessions stale) avant cette falaise.
2. Flux de données et backends de métriques
Un cycle :
- Check — requête
pg_stat_activity(actives, idle, démarrage backend, longues requêtes optionnelles). - Persistance — historique pour hystérésis, alertes de résolution et
/metrics. - Sortie — CSV optionnel ; HTTP optionnel
/metrics(Prometheus) et/healthz.
| Backend | Quand | Note |
|---|---|---|
| SQLite (défaut) | Moniteur local / un nœud | Recommandé. Évite une dépendance circulaire : si le réseau vers Postgres tombe, le moniteur continue d’écrire en local. |
| Postgres / Timescale | Historique de flotte | Centraliser les métriques en SQL. |
| MySQL | Métriques déjà dans MySQL | Dépendance réseau en plus ; seulement si c’est le standard. |
SQLite (et le store SQL) indexe par (client, cluster, database), pas par l’hôte de l’URL. Un client unique par entrée databases: si le même nom de base existe sur des hôtes différents.
Kubernetes : kube.postgres / -kube-postgres est un port-forward client-go, pas un sous-processus kubectl. Pas de databases: multi-entrées avec kube postgres dans le même processus (une entrée + kube : oui).
3. Détection et notification
Connexions stale
Âge de session (démarrage backend) contre un âge minimum et un seuil de compte stale ≥ 1. Les sessions idle éternelles fragmentent la mémoire et occupent des slots.
Trois niveaux et anti-bruit
L’utilisation vs max_connections utilise des bandes en pourcentage (défaut ~75 / 85 / 95 : Attention / Alert / Danger), plus idle et stale. Seul le niveau le plus haut du cycle déclenche — pas d’orage d’alertes si la charge traverse plusieurs bandes en un intervalle.
Depuis v1.1.0, les notifiers de seuil sont silencieux par défaut : transition, escalade, désescalade — pas chaque intervalle tant que l’état est mauvais. notifications.repeat_while_firing restaure le spam par intervalle de v1.0. PagerDuty : dedup_key stable et event_action: resolve à la reprise.
L’échec de connexion notifie toujours (notifiers configurés et pas -dry-run). Pas de flag opt-in. « too many clients already » → too_many_clients.
Canaux : Slack, Grafana Loki, PagerDuty, Microsoft Teams, webhook générique (HMAC-SHA256 optionnel). -test-max-connections surcharge la limite dans le moniteur seulement pour tester Danger sans toucher au GUC Postgres réel.
4. Chaîne d’approvisionnement (1.0+) et sécurité v1.1.1
- SBOM — SPDX et CycloneDX sur GitHub Releases.
- Cosign — images GHCR et bundle de checksums (Cosign v3).
- Image — distroless static Debian, non-root.
- v1.1.1 — Go 1.26.6 et
golang.org/x/netv0.56.0 (GO-2026-5942) ; Grype--fail-on high.
5. Multi-bases et ruptures 1.0
databases: est obligatoire (même pour une cible). db: a disparu. Voir UPGRADE-0.9-to-1.0.
Les seuils de comptage total / active ont disparu. Utiliser -db-threshold-levels. notify_on_connect_failure a disparu car l’échec de connexion alerte toujours.
Codes de sortie
| Code | Événement | Note DBRE |
|---|---|---|
| 0 | Succès | Check normal. |
| 1 | Config / validation | Faire échouer le deploy (CI). |
| 2 | Échec de connexion | Une cible : exit 2. Multi-database : log, saute la cible, continue. |
| 3 | Échec de requête stats | One-shot ; le daemon ne quitte pas sur erreur de query. |
| 4 | Échec de notificateur | Avec --strict. |
6. Dépôts
| Dépôt | Rôle |
|---|---|
| hrodrig/pgwd | CLI, checker, notifiers, image GHCR, releases. |
| hrodrig/pgwd-selfhosted | Compose, Helm, run/. Pas le moteur Go. |
Exemples opérateur : pgwd-selfhosted/run. Changelog : CHANGELOG.md.