Engineering-Report: pgwd v1.1.1
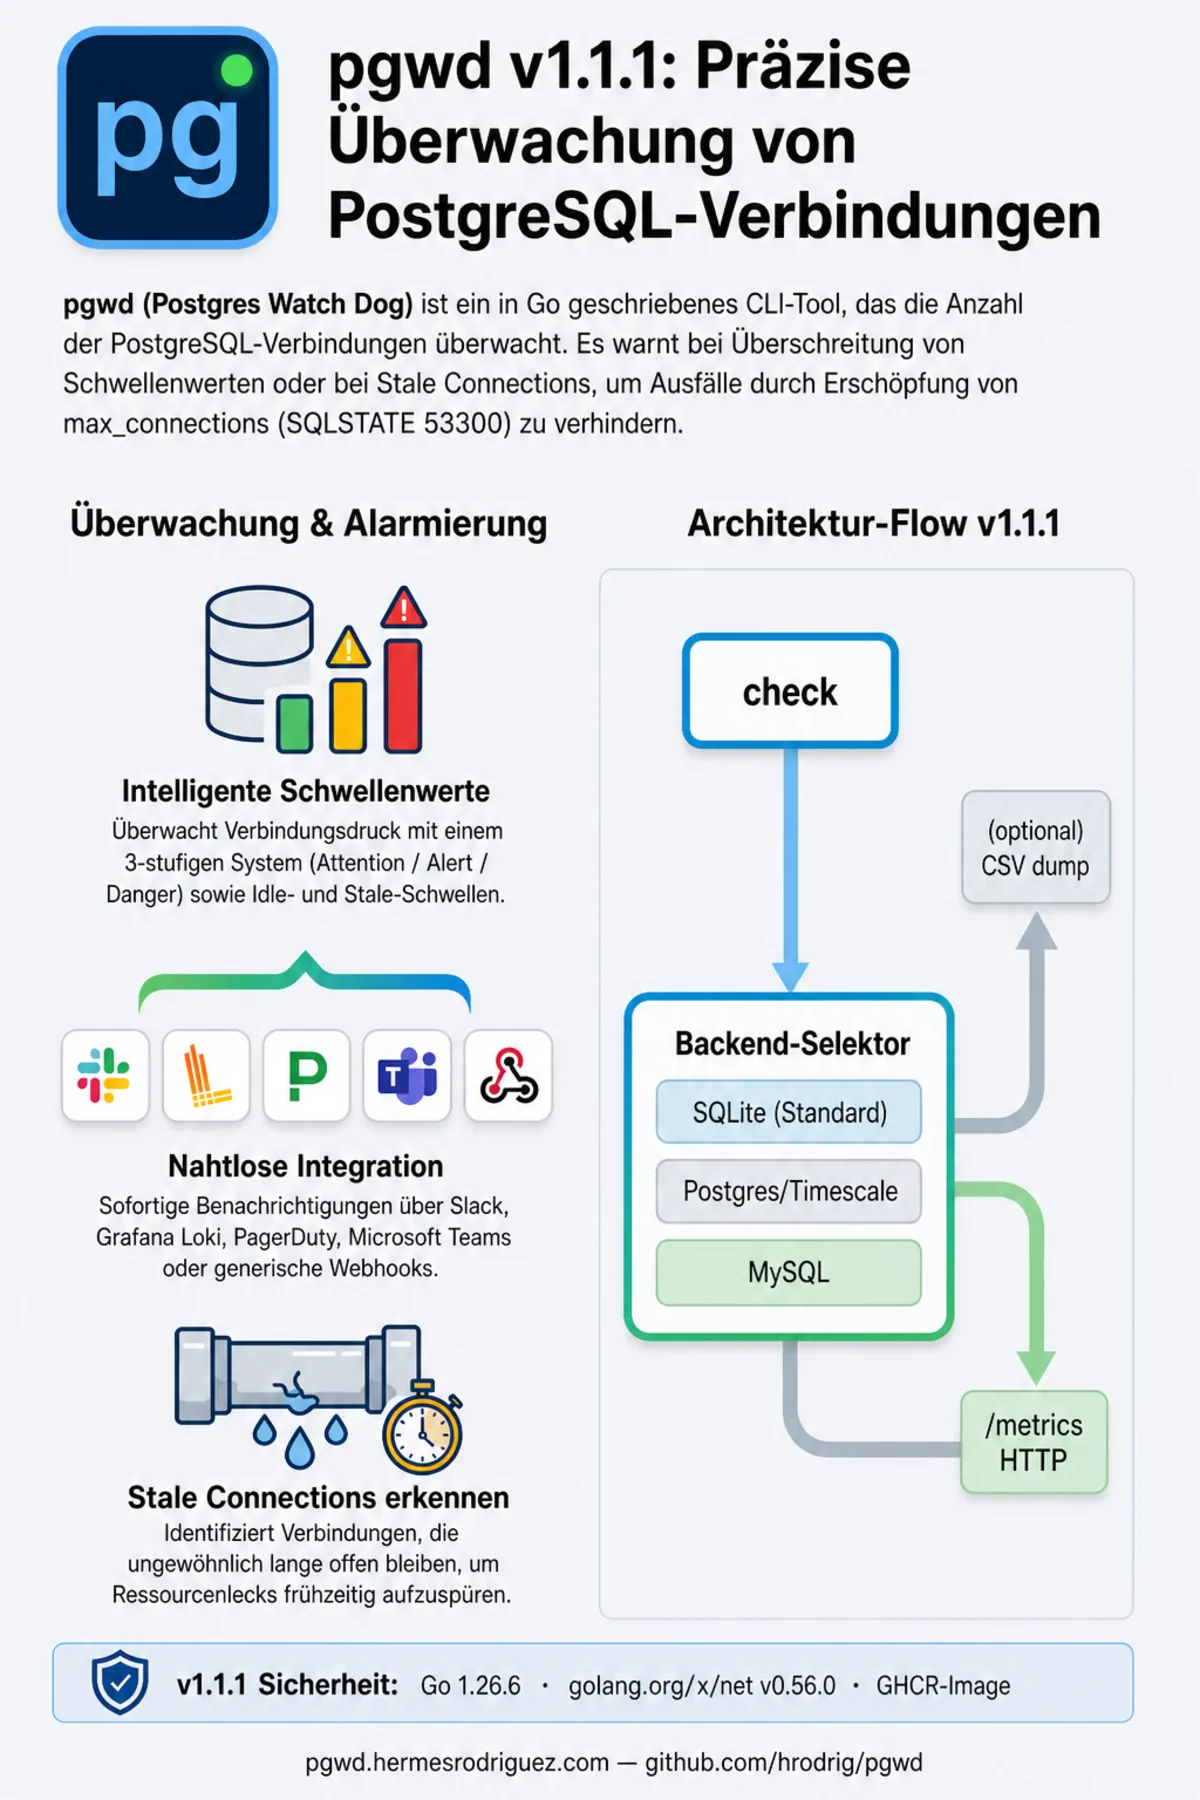
pgwd (Postgres Watch Dog) ist ein Go-CLI, das PostgreSQL-Verbindungsdruck misst und warnt, bevor Slots ausgehen. Es ersetzt keinen Pooler wie PgBouncer. Es ist ein spezialisierter Watchdog: Sichtbarkeit und Alerts — handeln musst du.
v1.1.1 (2026-08-31) ist ein Security-Patch auf der stabilen 1.0-API. Keine Breaking Changes in diesem Tag. Binary / GHCR-Image ziehen für Go 1.26.6 und golang.org/x/net v0.56.0.
1. Warum Connection-Slots zählen
In HA-Designs sind PostgreSQL-Slots knapp. Erschöpfung erscheint als SQLSTATE 53300 (too many clients already). Freie Slots sind nicht einfach max_connections: PostgreSQL reserviert Kapazität über superuser_reserved_connections und ab PostgreSQL 16+ reserved_connections.
Wenn keine Slots mehr da sind, ist Application-Traffic bereits blockiert. Oft parallel zu CPU-, I/O- und Speicherdruck (shared_buffers, work_mem), bis hin zu OOM. pgwd zeigt Attention / Alert / Danger (und Stale-Sessions), bevor diese Klippe kommt.
2. Datenfluss und Metrics-Backends
Ein Zyklus:
- Check —
pg_stat_activity(aktiv, idle, Backend-Start, optionale Long Queries). - Persistenz — Historie für Hysterese, Resolution-Alerts und
/metrics. - Ausgabe — optionales CSV; optionales HTTP
/metrics(Prometheus) und/healthz.
| Backend | Wann | Hinweis |
|---|---|---|
| SQLite (Standard) | Lokal / ein Knoten | Empfohlen. Keine zirkuläre Abhängigkeit: fällt das Netz zu Postgres aus, schreibt der Monitor weiter lokal. |
| Postgres / Timescale | Flottenhistorie | Metriken in SQL bündeln. |
| MySQL | Metriken schon in MySQL | Extra Netzabhängigkeit; nur als Org-Standard. |
SQLite (und der SQL-Store) keyed nach (client, cluster, database), nicht nach URL-Host. Pro databases:-Eintrag einen eindeutigen client, wenn derselbe DB-Name auf verschiedenen Hosts vorkommt.
Kubernetes: kube.postgres / -kube-postgres ist client-go Port-Forward, kein kubectl-Subprozess. Mehrere databases:-Einträge nicht zusammen mit kube postgres in einem Prozess (ein Eintrag + kube ist ok).
3. Erkennung und Benachrichtigung
Stale Connections
Sitzungsalter (Backend-Start) gegen konfiguriertes Mindestalter und Stale-Count-Schwelle ≥ 1. Langlebige Idle-Sessions fragmentieren Speicher und belegen Slots.
Drei Stufen und Rauschunterdrückung
Auslastung vs. max_connections über Prozentbänder (Standard ~75 / 85 / 95: Attention / Alert / Danger), plus Idle- und Stale-Schwellen. Nur die höchste Stufe im Zyklus feuert — keine Alert-Stürme, wenn die Last mehrere Bänder in einem Intervall durchläuft.
Ab v1.1.0 sind Threshold-Notifier standardmäßig ruhig: Transition, Eskalation, Deeskalation — nicht jedes Intervall im schlechten Zustand. notifications.repeat_while_firing stellt v1.0-Intervall-Spam wieder her. PagerDuty: stabiler dedup_key und event_action: resolve bei Recovery.
Connect-Failure benachrichtigt immer (wenn Notifier konfiguriert und nicht -dry-run). Kein Opt-in-Flag. „too many clients already“ wird als too_many_clients klassifiziert.
Kanäle: Slack, Grafana Loki, PagerDuty, Microsoft Teams, generischer Webhook (optional HMAC-SHA256). -test-max-connections überschreibt das Limit nur im Monitor, um Danger ohne echte Postgres-GUC zu testen.
4. Lieferkette (1.0+) und v1.1.1-Sicherheit
- SBOM — SPDX und CycloneDX auf GitHub Releases.
- Cosign — GHCR-Images und Checksum-Bundle (Cosign v3).
- Image — distroless static Debian, non-root.
- v1.1.1 — Go 1.26.6 und
golang.org/x/netv0.56.0 (GO-2026-5942); Grype--fail-on high.
5. Multi-Database und 1.0-Brüche
databases: ist Pflicht (auch für ein Ziel). db: ist weg. Siehe UPGRADE-0.9-to-1.0.
Feste total / active-Zählschwellen sind weg. Nutze -db-threshold-levels. notify_on_connect_failure entfällt, weil Connect-Failure immer alarmiert.
Exit-Codes
| Code | Ereignis | DBRE-Hinweis |
|---|---|---|
| 0 | Erfolg | Normaler Check. |
| 1 | Config / Validierung | Deploy failen (CI). |
| 2 | Connect-Fehler | Ein Ziel: Exit 2. Multi-Database: loggen, Ziel überspringen, weiter. |
| 3 | Stats-Query-Fehler | One-shot; Daemon beendet sich nicht bei Query-Fehlern. |
| 4 | Notifier-Fehler | Mit --strict. |
6. Repositories
| Repo | Rolle |
|---|---|
| hrodrig/pgwd | CLI, Checker, Notifier, GHCR, Releases. |
| hrodrig/pgwd-selfhosted | Compose, Helm, run/. Nicht die Go-Engine. |
Operator-Beispiele: pgwd-selfhosted/run. Changelog: CHANGELOG.md.