Informe técnico: pgwd v1.1.1
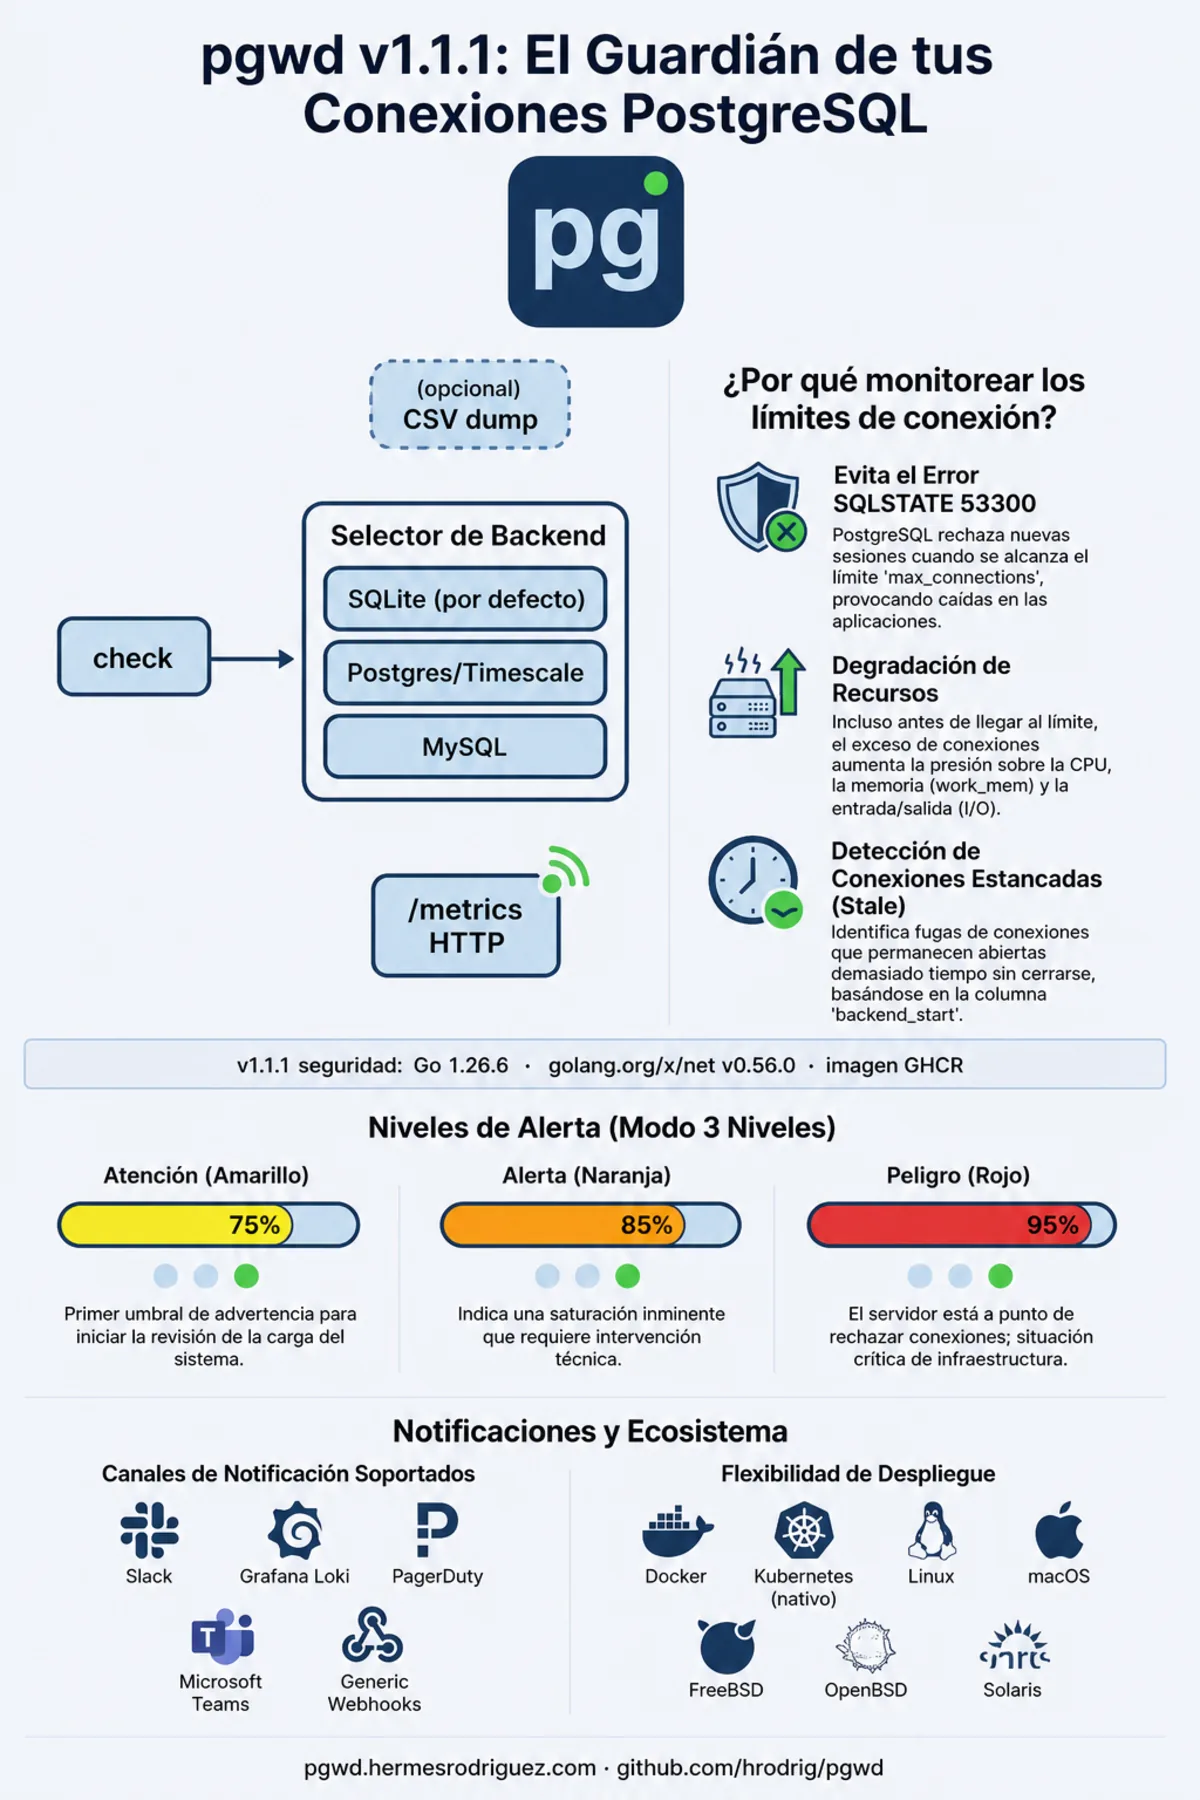
pgwd (Postgres Watch Dog) es un CLI en Go que muestrea la presión de conexiones PostgreSQL y avisa antes de que se agoten las ranuras. No sustituye a un pooler como PgBouncer. Es un watchdog especializado: visibilidad y alertas; la acción la tomas tú.
v1.1.1 (2026-08-31) es un parche de seguridad sobre la API estable 1.0. Este tag no rompe configuración. Hay que tirar del binario / imagen GHCR para Go 1.26.6 y golang.org/x/net v0.56.0.
1. Por qué importan las ranuras de conexión
En alta disponibilidad, las ranuras de PostgreSQL son un recurso escaso. Agotarlas aparece como SQLSTATE 53300 (too many clients already). Las ranuras libres no son solo max_connections: PostgreSQL reserva capacidad para roles privilegiados con superuser_reserved_connections y, desde PostgreSQL 16+, reserved_connections.
Cuando no quedan ranuras, el tráfico de la aplicación ya está bloqueado. Suele coincidir con presión de CPU, I/O y memoria (shared_buffers, work_mem) y puede anteceder un OOM. pgwd existe para que la guardia vea Attention / Alert / Danger (y sesiones stale) antes de ese acantilado.
2. Flujo de datos y backends de métricas
Un ciclo:
- Check — consulta a
pg_stat_activity(activas, idle, inicio de backend, consultas largas opcionales). - Persistencia — historial para histéresis, alertas de resolución y
/metrics. - Salida — CSV opcional; HTTP opcional
/metrics(Prometheus) y/healthz.
| Backend | Cuándo | Nota |
|---|---|---|
| SQLite (por defecto) | Monitor local / un nodo | Recomendado. Evita dependencia circular: si cae la red hacia Postgres, el monitor sigue registrando en local. |
| Postgres / Timescale | Historial de flota | Centralizar métricas en SQL. |
| MySQL | Métricas ya en MySQL | Dependencia de red extra; solo si es el estándar del equipo. |
SQLite (y el store SQL) indexa por (client, cluster, database), no por el host de la URL. Asigna un client único por entrada de databases: si el mismo nombre de base existe en hosts distintos.
Kubernetes: kube.postgres / -kube-postgres es port-forward con client-go, no un subproceso kubectl. No se puede combinar databases: multi-entrada con kube postgres en el mismo proceso (una sola entrada + kube sí).
3. Detección y notificación
Conexiones stale
Usa la edad de sesión (inicio de backend) frente a una edad mínima y un umbral de conteo stale ≥ 1. Las sesiones idle eternas fragmentan memoria y ocupan ranuras.
Tres niveles y supresión de ruido
La utilización frente a max_connections usa bandas porcentuales (por defecto ~75 / 85 / 95: Attention / Alert / Danger), más umbrales idle y stale. Solo dispara el nivel más alto del ciclo, para no inundar cuando la carga cruza varias bandas en un intervalo.
Desde v1.1.0, las notificaciones de umbral están silenciosas por defecto: disparan en transición, escalada y desescalada, no en cada intervalo mientras el mal estado persiste. notifications.repeat_while_firing restaura el spam por intervalo de v1.0. PagerDuty usa dedup_key estable y event_action: resolve al recuperarse.
El fallo de conexión siempre notifica (si hay notifiers y no es -dry-run). No hay flag opt-in. Un error “too many clients already” se clasifica como too_many_clients.
Canales: Slack, Grafana Loki, PagerDuty, Microsoft Teams, webhook genérico (HMAC-SHA256 opcional). -test-max-connections sobrescribe el límite solo en el monitor para ensayar Danger sin tocar el GUC real.
4. Cadena de suministro (1.0+) y seguridad v1.1.1
- SBOM — SPDX y CycloneDX en GitHub Releases.
- Cosign — imágenes GHCR y bundle de checksums (Cosign v3).
- Imagen — distroless static Debian, non-root.
- v1.1.1 — Go 1.26.6 y
golang.org/x/netv0.56.0 (GO-2026-5942); Grype--fail-on highen la imagen.
5. Multi-base y roturas de 1.0
databases: es obligatorio (aunque haya un solo destino). La clave db: desapareció. Guía: UPGRADE-0.9-to-1.0.
Se eliminaron umbrales fijos total / active. Usa -db-threshold-levels. notify_on_connect_failure desapareció porque el fallo de conexión siempre alerta.
Códigos de salida
| Código | Evento | Nota DBRE |
|---|---|---|
| 0 | Éxito | Check normal. |
| 1 | Config / validación | Fallar el deploy (CI). |
| 2 | Fallo de conexión | Un destino: sale 2. Multi-database: log, salta ese destino, sigue. |
| 3 | Fallo de query de stats | One-shot; el daemon no sale por errores de query. |
| 4 | Fallo de notificador | Con --strict. |
6. Repositorios
| Repo | Rol |
|---|---|
| hrodrig/pgwd | CLI, checker, notifiers, imagen GHCR, releases. |
| hrodrig/pgwd-selfhosted | Compose, Helm, layout run/. No es el motor Go. |
Ejemplos de operador: pgwd-selfhosted/run. Changelog: CHANGELOG.md.